


Разбираем, почему AI-контент не попадает в выдачу: индексация, структура, AI Overviews. Что проверить на 1С-Битрикс и исправить первым.

Отвергают ли поисковики страницу только потому, что текст создал ИИ?
Нет: сам факт генерации текста нейросетью не определяет попадание в выдачу. AI Overviews в Google и нейропоиск на базе YandexGPT оценивают не автора, а страницу — доступность, соответствие запросу и надёжность. Условий три. — Техническая доступность: страницы, закрытые в robots.txt или noindex и подгружаемые скриптом, игнорируются независимо от авторства. — Соответствие запросу и извлекаемость: важны автономные фрагменты — H2–H3, списки, абзацы в 3–4 строки, микроразметка Schema.org (Article, FAQPage, HowTo); про AEO (Answer Engine Optimization) и GEO (Generative Engine Optimization) — подробнее. — Полезность и надёжность: авторство, дата, источники, конкретика. Бесструктурное «полотно» проигрывает не из-за происхождения, а из-за того, что из него нечего извлечь.
Четыре причины, мешающие AI-контенту попасть в органическую выдачу
Страница не проиндексирована
закрытие в robots.txt, noindex, canonical на другой URL или подгрузка текста скриптом — и алгоритму нечего оценивать. Проверьте отчёты по индексации в Search Console и «Яндекс.Вебмастере».
Текст без своих данных
пересказ чужих статей дословно повторяет уже проиндексированные страницы и не отвечает на уточняющие вопросы. Добавьте собственные примеры, наблюдения и практику.
Нет ответа на запрос и проверяемых фактов
заголовок обещает одно, а текст уходит в общие рассуждения. Дайте прямой ответ в начале и конкретику: цифры, даты, названия инструментов, источники, ограничения и исключения.
Структура мешает извлечь смысл
поиск собирает ответ из автономных фрагментов. Один H1, логичные H2–H3, списки, таблицы и абзацы в 3–4 строки помогают выделить блок, а Schema.org (Article, FAQPage, HowTo) и метаданные с автором и датой подсказывают тип материала. См. как писать статьи.
Почему присутствия в обычной выдаче недостаточно для попадания в AI-ответ?
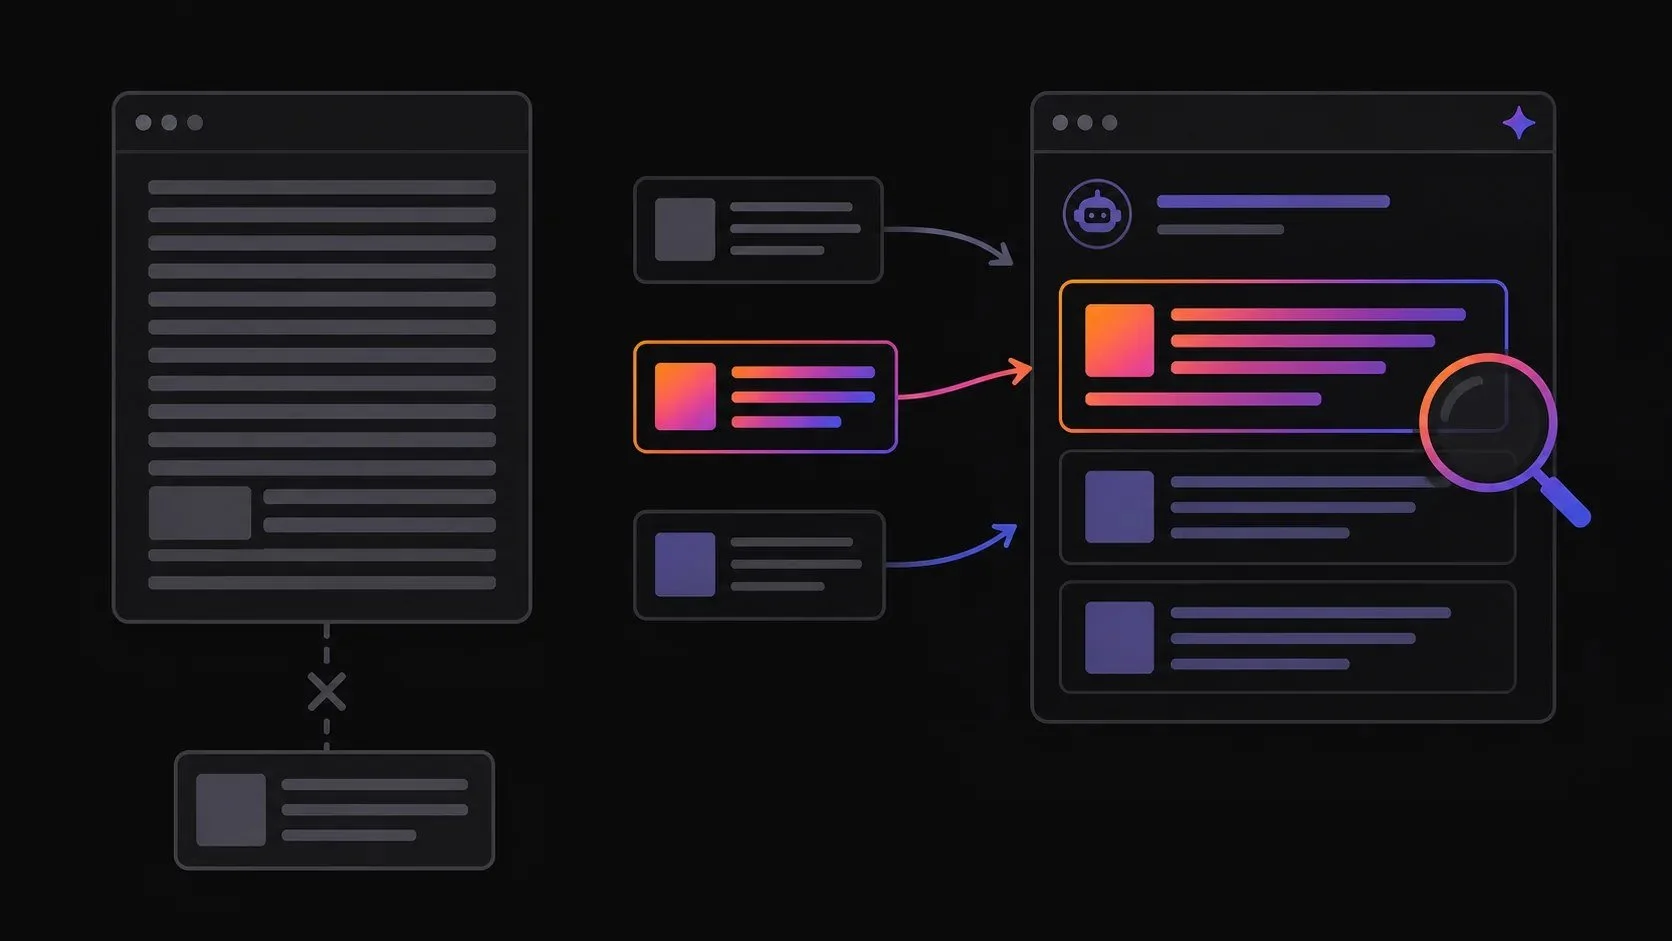
В обычной выдаче показывается страница, в AI-ответе цитируется фрагмент. Ранжирование оценивает документ целиком — релевантность, ссылочный профиль, поведенческие сигналы, — а генеративная выдача собирает ответ из автономных блоков. Поэтому статья может уверенно стоять в выдаче и не попасть ни в AI Overviews, ни в нейропоиск на базе YandexGPT. Для AI-ответа нужен самодостаточный фрагмент: прямой ответ, список, таблица, инструкция. С запросом он сверяется целиком, и приоритет получает тот, что короче и точнее закрывает интент; разметка Schema.org (Article, FAQPage, HowTo), авторство и дата подтверждают надёжность. Вывод: позиция в выдаче — не пропуск в AI-ответ, и добиваться стоит не места, а извлекаемых фрагментов под конкретные вопросы. Как выстроить страницу под это — контент для AI-поиска.
Что проверить на сайте на 1С-Битрикс, если страницы не видны в поиске?
- В 1С-Битрикс страницы закрывают robots.txt, noindex в разделе/инфоблоке или canonical. Проверьте robots.txt и настройки инфоблоков. Дубли URL сведите через 301 и canonical; в sitemap.xml — только канонические URL.
- Робот получает контент: при выводе текста, цен, заголовков через AJAX, ленивую подгрузку или JS в HTML — пустой контейнер. В коде без JS нужны H1, title, description; один H1. Schema.org не гарантирует AI-ответ.
Как связи с услугами и регионом помогают нейросетям понять статью?
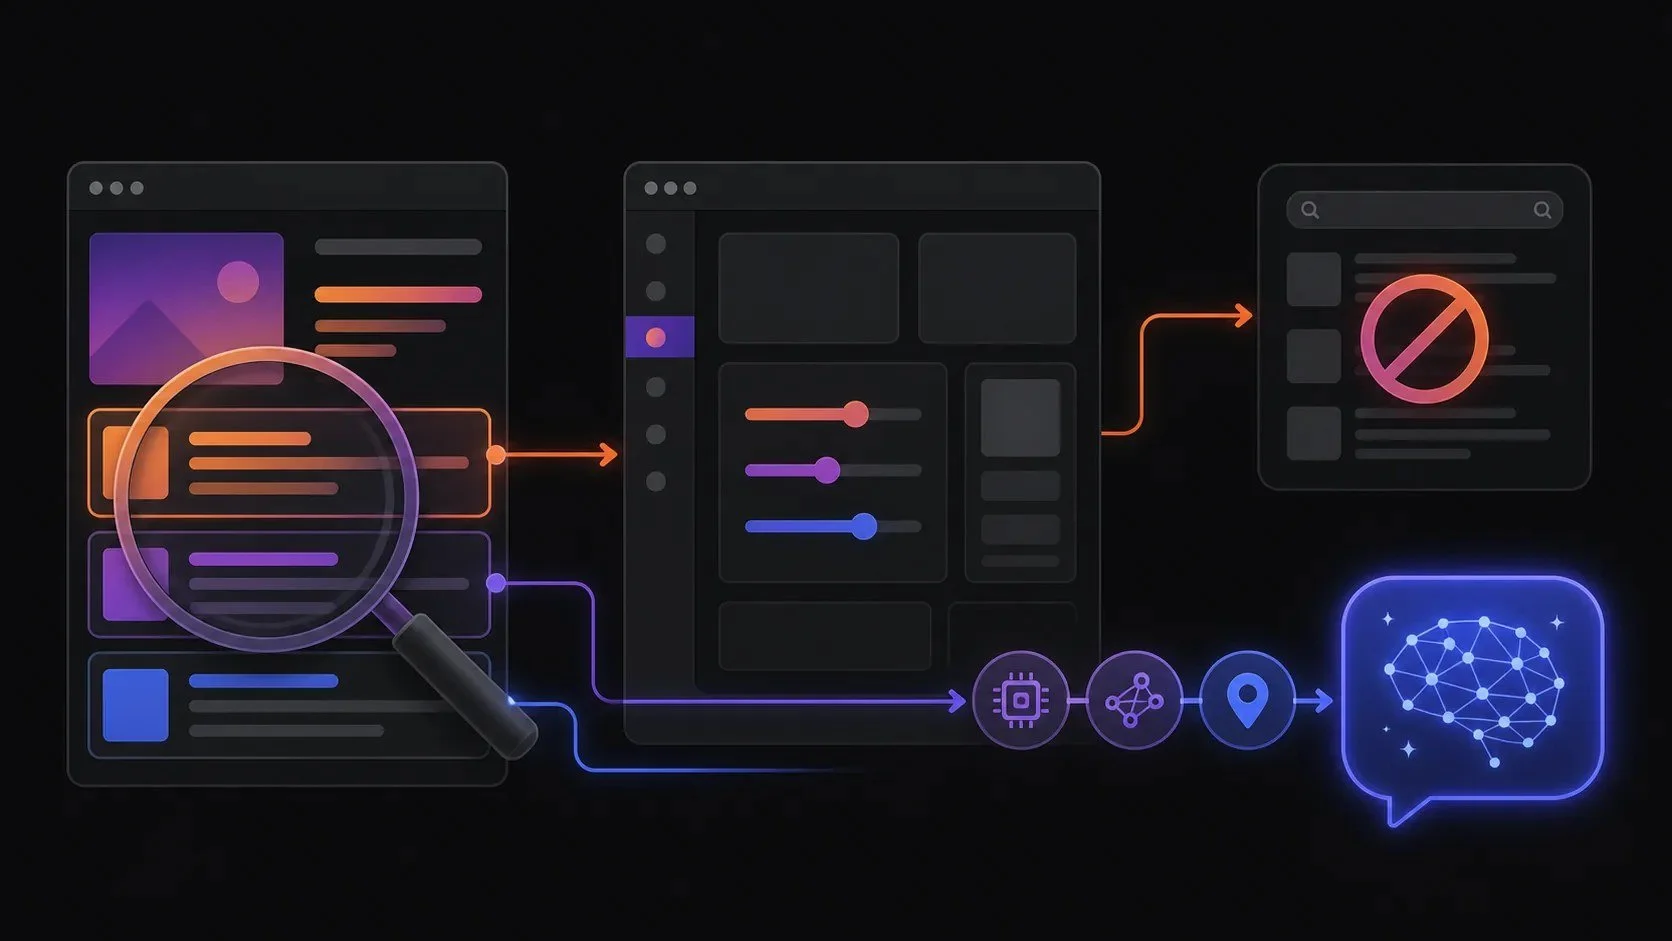
Как найти причину и определить, что исправлять в первую очередь?
- Проверьте индексирование и техническое состояниеначните с панелей вебмастера: отчёты об индексации в Search Console и «Яндекс.Вебмастере» показывают, доступен ли URL роботу и что именно его блокирует — robots.txt, noindex, canonical, отсутствие адреса в sitemap.xml, пустой контейнер вместо контента без JS. Если страницы в базе нет, остальные проверки можно отложить: причина уже найдена.
- Сопоставьте материал с запросом и конкурентамиопределите интент за запросом и сравните свою страницу с тем, что поиск уже показывает по этому запросу. Отметьте, какие фрагменты извлекаются у других: прямой ответ, список, таблица, инструкция. Расхождения с этими блоками и станут первым списком правок.
- Оцените полноту и оригинальность содержанияпроверьте, есть ли в тексте то, чего нет у других: собственные данные, примеры, ограничения, исключения. Пересказ чужих материалов не добавляет алгоритму нового. Отметьте, каких блоков не хватает вашей странице относительно выдачи, — это и есть зона роста.
- Расставьте приоритет доработоксначала правьте то, что блокирует показ: индексирование, подача контента без скриптов, соответствие интенту. Затем — структуру, микроразметку и уникальные факты. Работы, влияющие на попадание в базу и извлечение фрагментов, как правило, идут раньше косметических правок в тексте.
- Отслеживайте изменения в поисковой видимостизафиксируйте метрики до правок: показы и переходы по конкретным запросам в панелях вебмастера, наличие страницы в AI-ответах, извлекаемые фрагменты. После доработки сравните те же срезы — так видно, что сработало, а что требует повторной проверки.
- Выберите: аудит или точечная оптимизацияточечных работ достаточно, если проблема на одной странице: слабый ответ на запрос, пустой контейнер без JS, отсутствие разметки. Аудит нужен, когда проблема в шаблонах, дублях или целых разделах. В этом случае проверьте сайт целиком и составьте план: аудит, разовые работы.
Частые вопросы об AI-контенте и поисковой видимости
Что важнее для попадания в AI-ответ: структура или авторство?
Структура и надёжность. Отдельного наказания за то, что текст сгенерирован нейросетью, в ранжировании нет: страницу оценивают целиком — доступность для робота, соответствие запросу, извлекаемость фрагментов. Текст без структуры проигрывает не из-за происхождения, а из-за отсутствия извлекаемых блоков.
Микроразметка гарантирует попадание в AI-ответ?
Нет: Schema.org (Article, FAQPage, HowTo) — лишь подсказка о типе материала, а не пропуск в цитирование. Какой фрагмент подставить в ответ, алгоритм решает сам. Разметка помогает интерпретации и rich-сниппетам, но не заменяет прямой ответ: оптимизация FAQ.
Обязательно ли переписывать уже опубликованные статьи?
Нет. Правьте только то, что мешает показу или извлечению: техническую доступность, структуру, отсутствие уникальных данных. Пошаговая диагностика — в пункте 3 раздела о поиске причин; метрики сверяйте до и после правок.
Почему страница в индексе, но её не цитируют в AI-ответах?
Тогда причина в извлекаемости: алгоритму нужен самодостаточный блок с прямым ответом, а не вывод в конце текста. Добавьте короткий ответ на вопрос, список или таблицу — фрагмент должен читаться вне контекста. Если страницы в базе нет вовсе, начинайте с проверки индексирования.
Расскажите о задаче — оценим сроки и объём работ по вашему проекту.